Dies ist der dritte Teil unserer vierteiligen Blogreihe, in der wir erläutern, wie wir die Tanium-Plattform in unserem eigenen Unternehmen einsetzen. In diesem Beitrag erläutert SecOps-Ingenieur Greg Pothier, wie Tanium und Splunk gemeinsam genutzt werden können, um Daten zum Patch-Management bereitzustellen, auf die CSOs und andere Führungskräfte im Sicherheitsbereich zurückgreifen können, um potenzielle Risiken zu bewerten.
Erfassung der mittleren Zeit
Inwieweit wäre es sinnvoll, die durchschnittliche Zeit bis zur Installation eines Patches für jedes Gerät in Ihrem Netzwerk zu erfassen? Wie wäre es, wenn Sie jederzeit, sobald Ihr CIO, CSO oder VP of Ops danach fragt, sofort genaue Ergebnisse zur Anzahl der offenen Patches liefern könnten?
Das waren Fragen, die wir uns hier bei Tanium zu stellen begannen. Die Antworten bieten einen echten geschäftlichen Mehrwert für unsere Sicherheits- und IT-Verantwortlichen, die die Daten nutzen können, um unsere Angriffsfläche und die Patch-Performance kontinuierlich zu überwachen.
Es stimmt zwar, dass die meisten Unternehmen nicht einmal den aktuellen Stand der Patches in ihrem Netzwerk kennen, doch bei Tanium tun wir nicht nur dies, sondern haben zudem eine Kennzahl entwickelt, um die durchschnittliche Zeit zu erfassen, die für die Installation von Patches benötigt wird.
Dies ist die präziseste Methode, mit der wir bei Tanium die Tanium-Plattform nutzen, um Kennzahlen darüber zu erheben, wie gut unser Unternehmen das Patch-Management umsetzt. Mit Tanium lassen sich selbst in den größten Unternehmen auf einfache Weise präzise Ergebnisse erfassen, wie beispielsweise offene kritische Patches und der Status jeder installierten Anwendung. Für CSO und andere Sicherheitsverantwortliche ist ein Überblick über offene Sicherheitslücken im gesamten Unternehmen eine wichtige Kennzahl, da er ihnen dabei hilft, das Risikopotenzial einzuschätzen. Mit Tanium können wir noch einen Schritt weiter gehen und die Qualität unserer Patch-Installationen messen, indem wir die durchschnittliche (mittlere) Zeit ermitteln, die für die Installation von Patches im gesamten Unternehmen benötigt wird. So setzen wir dies um: mithilfe von Tanium und Splunk (wird in einem neuen Tab geöffnet), einem Datenanalyse-Tool.
Tanium Connect
Zunächst richten wir eine Tanium- ein: Connect (wird in einem neuen Tab geöffnet) , die unsere Tanium-Abfrage „Computernamen, Betriebssystem und verfügbare Patches aller Rechner abrufen“ an Splunk übermittelt. Das Betriebssystem ist optional; wir fügen es hinzu, für den Fall, dass wir die Ergebnisse in Zukunft nach bestimmten Betriebssystemen filtern möchten.
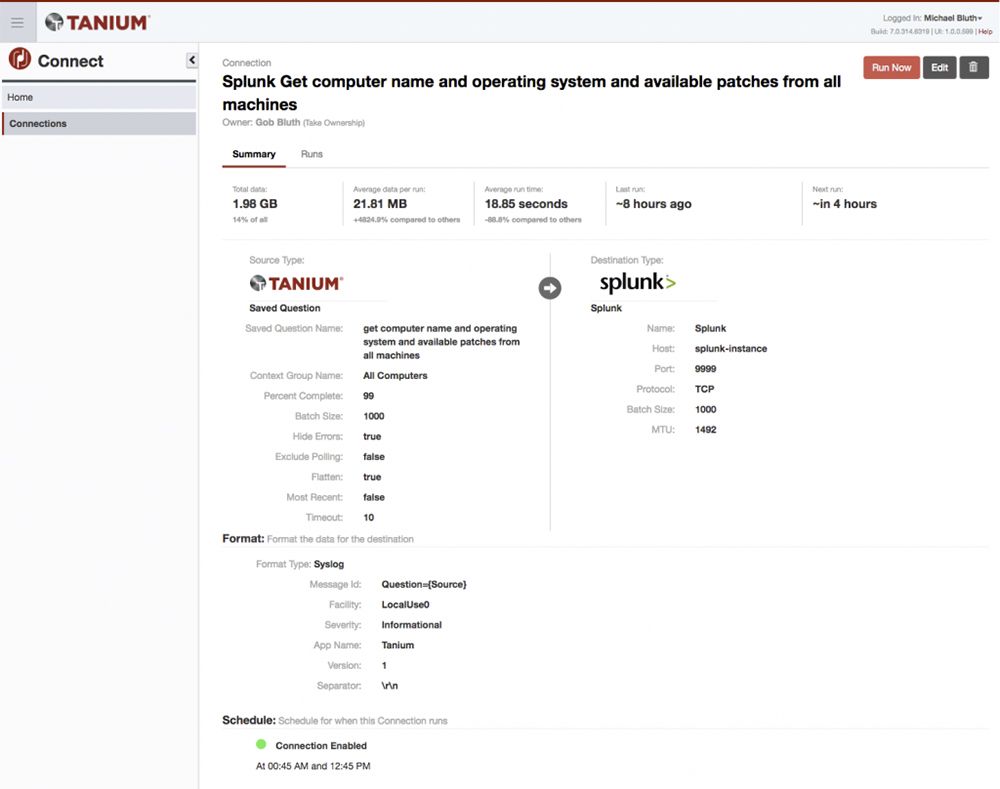
Nachdem die Verbindung in Tanium eingerichtet wurde, führen wir sie aus und überprüfen in Splunk, ob die Ergebnisse wie erwartet verarbeitet werden. Wir beginnen die Suche mit der Abfrage „index=‘tanium’“, da wir diese Verbindung so konfiguriert haben, dass sie unter dem Namen „Tanium“ indexiert wird. Anschließend fügen wir Folgendes hinzu:
<code>index=“tanium“
Question=“Computer-Name, Seriennummer und verfügbare Patches aller Rechner abrufen“
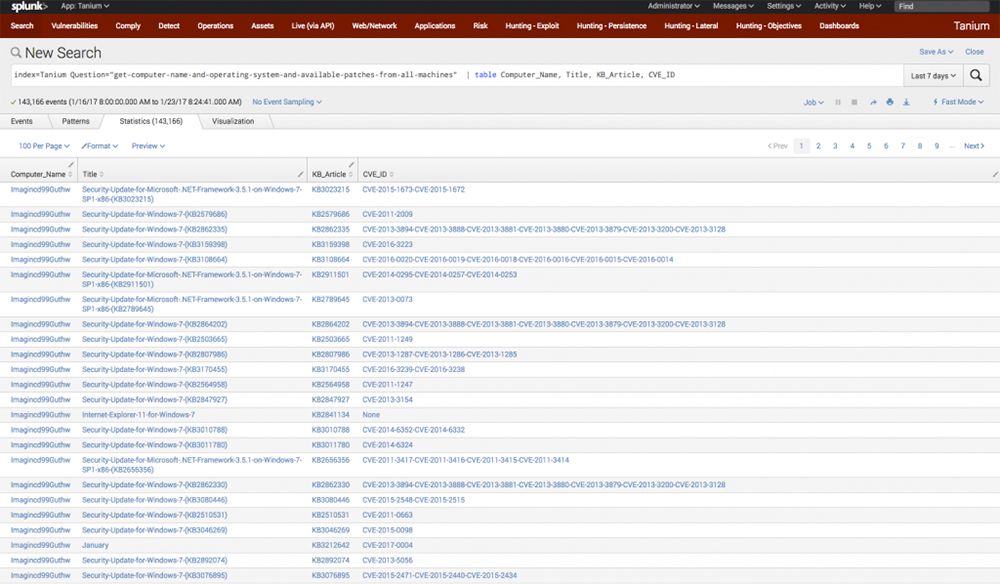
</code>Hier werden alle verfügbaren Patch-Ergebnisse nach Computernamen sortiert aufgelistet. Nun verfügen wir über eine Liste aller Patches, einschließlich Titel, Schweregrad, CVE-ID usw. (Anmerkung von : Wir verwenden im folgenden Screenshot eine Tabelle zur Darstellung der Ergebnisse ausschließlich aus Gründen der besseren Übersichtlichkeit; diese Formatierung ist ansonsten nicht erforderlich.)
An dieser Stelle erstellen wir eine übersichtliche grafische Darstellung der Patches nach Schweregrad. Um sicherzustellen, dass wir keine doppelten Ergebnisse verarbeiten, leiten wir die Verbindungsdaten an eine Deduplizierungsfunktion weiter, beispielsweise:
<code>| dedup Computer_Serial_Number, KB_Article, CVE_ID, Title</code>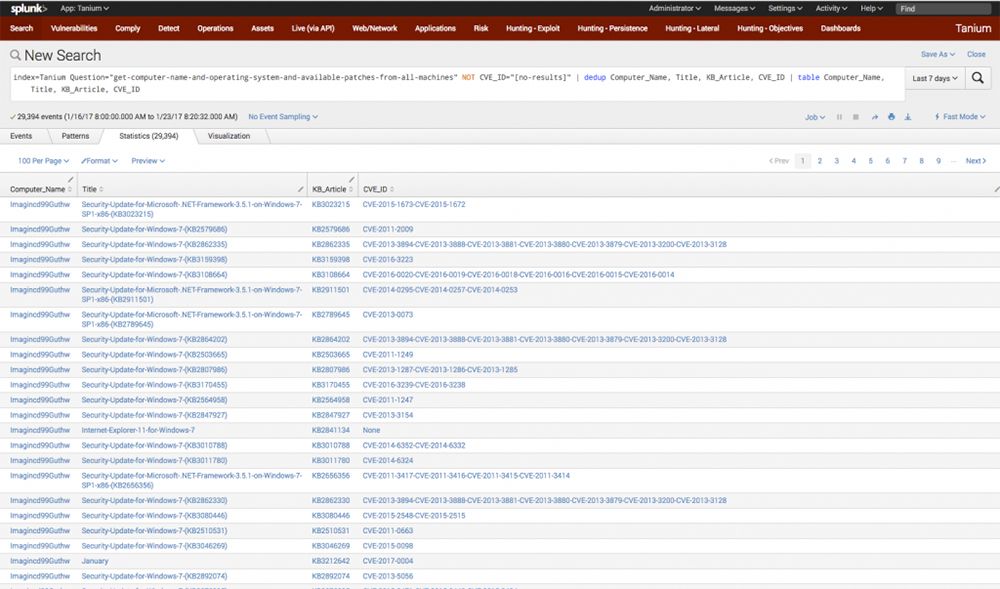
Dadurch wird sichergestellt, dass diese Werte (Computer_Serial_Number, KB_Article, CVE_ID, Title) nur einmal gemeldet werden und somit eindeutig sind. Sobald wir die eindeutigen Werte haben, führen wir eine einfache Funktion aus, um die Ergebnisse nach Schweregrad grafisch darzustellen:
<code>| Anzahl der Diagramme nach Schweregrad
</code>Die Ergebnisse ergeben ein anschauliches Diagramm, das sowohl die Gesamtanzahl der einzelnen Schweregrade als auch deren prozentualen Anteil veranschaulicht:
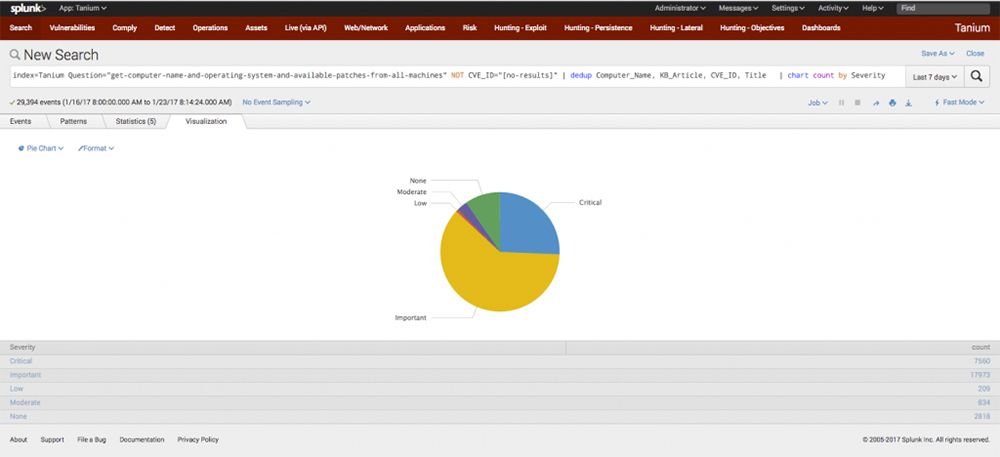
Nun verfügen wir über ein zuverlässiges, automatisiertes Dashboard, in dem die derzeit offenen Patches nach Schweregrad geordnet angezeigt werden. Bitte beachten Sie, dass wir dies problemlos auch für Computer mit anderen Betriebssystemen, wie beispielsweise Linux oder Mac OS X, durchführen könnten. Lassen Sie uns unser Ziel weiterverfolgen, eine automatisierte Lösung zu entwickeln, die die durchschnittliche Zeit bis zur Fehlerbehebung berechnet und anzeigt.
Als Nächstes kehren wir zu unserer Basisabfrage zurück und deaktivieren die Duplikatsbereinigung, damit wir mit allen eingegangenen Patch-Protokollen arbeiten können. Anschließend fügen wir hinzu:
<code>| stats earliest(_time) als „First“, latest(_time) als „Last“ nach Computer_Name, CVE_ID, Severity, Title</code>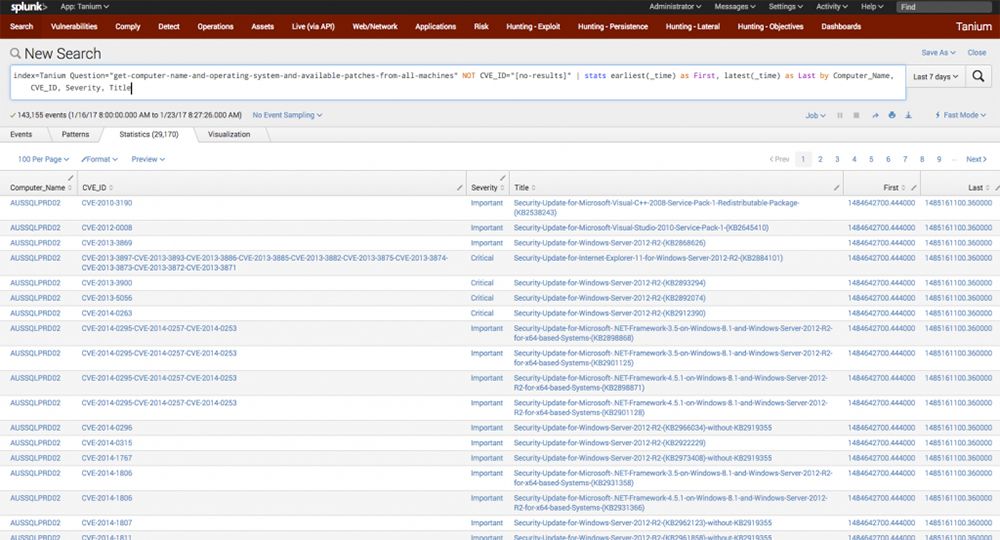
Hierbei wird die Statistikfunktion genutzt, um zu überprüfen, wann der Patch zum ersten Mal gemeldet wurde sowie wann er zum letzten Mal gemeldet wurde – aufgeschlüsselt nach Computername, CVE-ID, Schweregrad und Titel. Dieser Bericht liefert uns einen Zeitstempel, aus dem hervorgeht, wann die Patches zum ersten Mal und zum letzten Mal festgestellt wurden. Nun berechnen wir die Differenz der beiden Werte, um die Dauer zu ermitteln, und wandeln anschließend das Epoch-Zeitformat in eine lesbare Zeichenfolge um:
<code>| eval diff = Last - First | eval diff2 = tostring(diff, "Dauer")</code>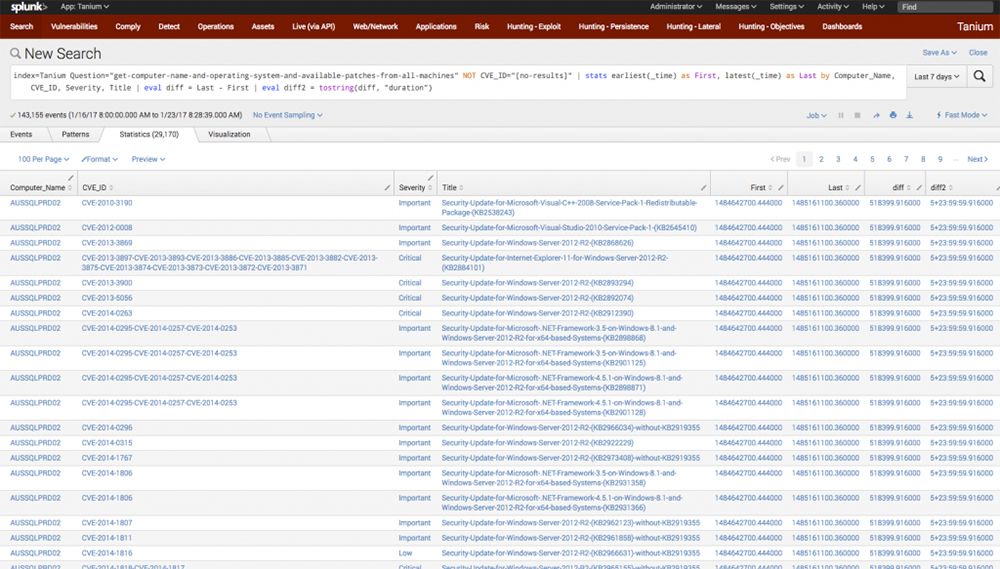
In den Ergebnissen werden der Computername, die Patch-Informationen sowie die Dauer aufgeführt, für die jeder Patch auf dem jeweiligen Computer als offen gemeldet wurde. Nun berechnen wir das tatsächliche Maximum, Minimum und den Mittelwert dieser Differenzwerte:
<code>| Anzahl der Werte, max(Differenz), min(Differenz), Mittelwert(Differenz)
</code>Und das war’s. Wir kennen nun die Maximal-, Minimal- und Mittelwerte aller Bereiche. Wir gestalten die Ausgabe übersichtlicher, indem wir „mean(diff)“ in „average“ umbenennen, die zusätzlichen Dezimalstellen abrunden und eine ansprechend formatierte Zeichenfolge erstellen, die die Stunden, Minuten usw. des Tages anzeigt.
<code>| „mean(diff)“ in „average“ umbenennen | „average“ berechnen = „average“ runden( 0) | „averageTime“ berechnen = „average“ tostring(</code>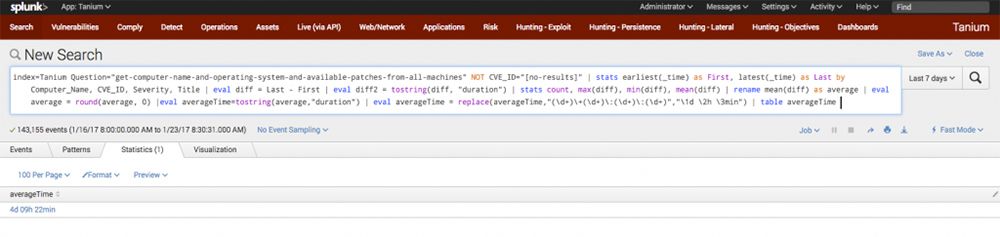
In diesem Blogbeitrag haben wir eine gespeicherte Frage aus Tanium verwendet, die einmal täglich über Tanium Connect an Splunk gesendet wird, um zwei wichtige, automatisierte Metriken zu erstellen. Die IT-Führung kann diese Informationen nutzen, um unsere Angriffsfläche und unsere Patching-Leistung zu bewerten – sowohl im aktuellen Zustand als auch im Zeitverlauf.
Dies ist der dritte Teil einer vierteiligen Serie. In „ “ (), Teil 1 (), erläutere ich, wie wir bei Tanium kritische Sicherheitslücken nachverfolgen. In „ “ (), Teil 2: „“, beschreibe ich, wie wir Tanium einsetzen, um wichtige Compliance-Kennzahlen zu überwachen. In „ “ (), Teil 4 (), gebe ich Leitlinien zur durchschnittlichen Reaktionszeit und erläutere, warum schnelle Reaktionszeiten für jedes Unternehmen von entscheidender Bedeutung sind.
Über den Autor: Greg Pothier ist Sicherheitsingenieur bei Tanium und verfügt über Erfahrung in den Bereichen Sicherheitsautomatisierung, Datenanalyse, Penetrationstests und Softwareentwicklung. Vor seiner Tätigkeit bei Tanium war Greg als leitender Ingenieur bei mehreren US-Geheimdiensten und Regierungsbehörden tätig. Greg schloss sein Masterstudium der Informatik an der George Mason University ab, wo ihm das „NSA Information Assurance Cyber Scholarship“ verliehen wurde.

